時系列データの変換

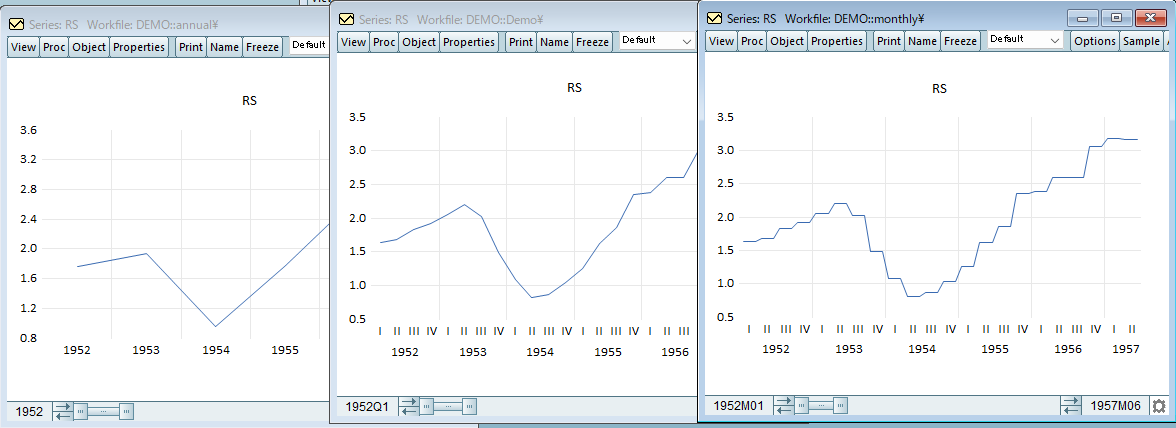
EViewsでは時系列データ・パネルデータの頻度(データの粒度)を変換する多数の手法を提供しています。基本は収録頻度の異なるページ間で、データをコピーアンドペーストまたはドラッグアンドドロップするだけです。
操作方法

コピーアンドペースト

  1. 2つのワークファイルページ(またはソースデータベースと宛先ワークファイルページ)がある場合、同じワークファイル内のページ間、または別々のワークファイル間でコピーできます。
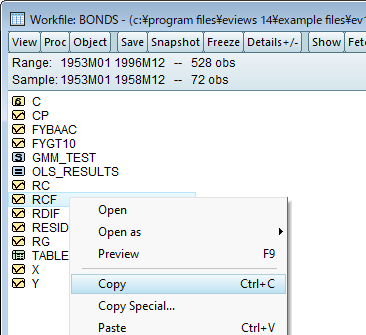
    右クリック/Copy
    データ
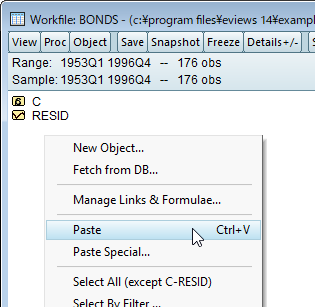
    変換先ページで右クリック/PasteまたはPaste special
    データ
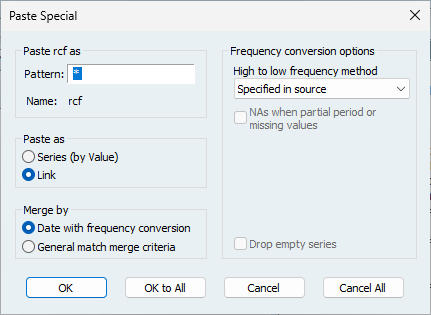
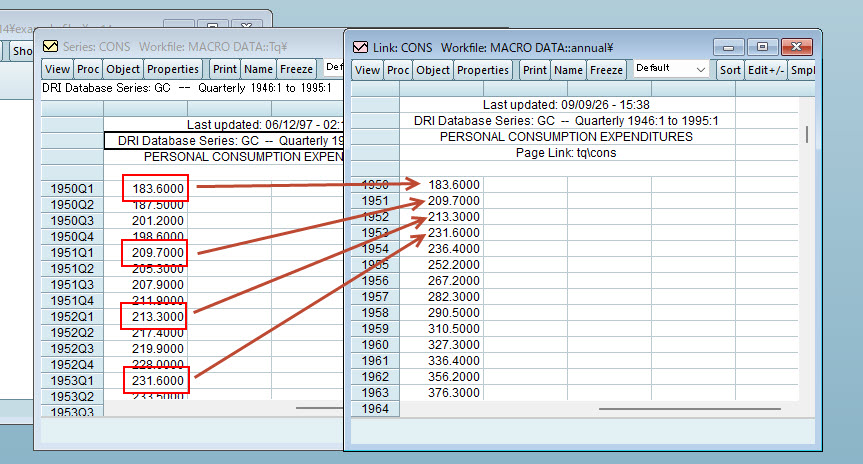
    特定の系列を四半期データから年次データに変換するには、ソースの四半期ワークファイルから年次ワークファイルに系列をコピー&ペーストします。四半期ワークファイルで変換したい系列をクリックし、右クリックしてCopyを選択します。次に、年次ワークファイルに移動し、右クリックしてPasteまたはPaste specialを選択します。Pasteを選択すると、EViewsはデフォルトの頻度変換設定を使用して、対象の系列を年次ページにコピーします。
    データ
    Pattern編集ボックスは貼り付け先における名前を編集します。デフォルトは「*」ワイルドカードになっており、元の変数名をそのまま利用します。
    Paste asセクションでは、数値のみをコピーするか、源系列とリンクするかを選択します。リンクされたシリーズは元データを編集すると、それに対応して自動的に変更されます。
    Frequency conversion optionsセクションでは変換方法を選択できます。サポートしている手法は下記の「変換手法(高頻度から低頻度)」をご覧ください。NAs when partial period or missing valuesにチェックを入れると、元データの対象区間に欠損値がある場合、NAを返します。
  2. ドラッグアンドドロップ
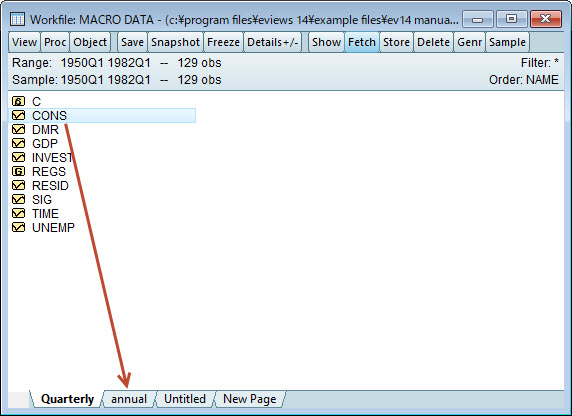
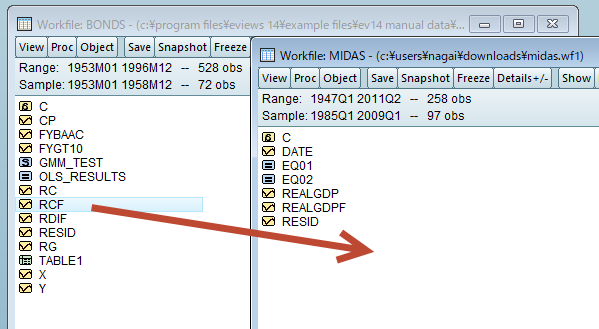
    コピー&ペーストの代わりに、ドラッグ&ドロップでワークファイルページ間でファイルをコピーすることもできます。コピーしたいシリーズを選択し、コピー先のページタブにドラッグ&ドロップするだけです。右クリックでシリーズを選択すると、新しいタブにドロップしたときにPaste specialダイアログが表示されます。ワークファイルページのタブをワークファイルウィンドウにドラッグ&ドロップして、あるワークファイルページのすべてのオブジェクトを別のワークファイルページにコピーすることもできます。コピーするオブジェクトの種類やワークファイルの頻度によっては、貼り付けを正しく完了するためのプロンプトが表示される場合があります。

    ページ間
    データ

    ワークファイル間
    データ
  3. コマンド操作
    ワークファイル間、またはデータベースとワークファイル間で系列を移動するには、copyまたはfetchコマンドのいずれかを使用できます。ソースと宛先の頻度が一致しない場合、EViewsは頻度変換を実行します。構文の詳細は開発ヘルプをご覧ください。
    ワークファイルのページ間で系列をコピーする場合の構文は次のように記述します。
    copy(オプション) 元ファイルのページ名\元シリーズ名 宛先ページ名\
    他のワークファイル内のシリーズをコピーする場合は、次のように記述します。ファイル同士が同じ作業フォルダ内にあれば、ファイルディレクトリは省略できます。
    copy(オプション) 元ファイルのディレクトリ\元ワークファイル名::元ファイルのページ名\元シリーズ名 宛先ファイルのディレクトリ\宛先ワークファイル名::宛先ページ名\
    次の例は、1990年から2000年間について、同じワークファイル内のqaurterlyページにあるcons系列を、annualページに平均値としてコピーするものです。
    copy(smpl="1990 2000", c=mean) quarterly\cons annual\
  4. デフォルトの変換手法の変更
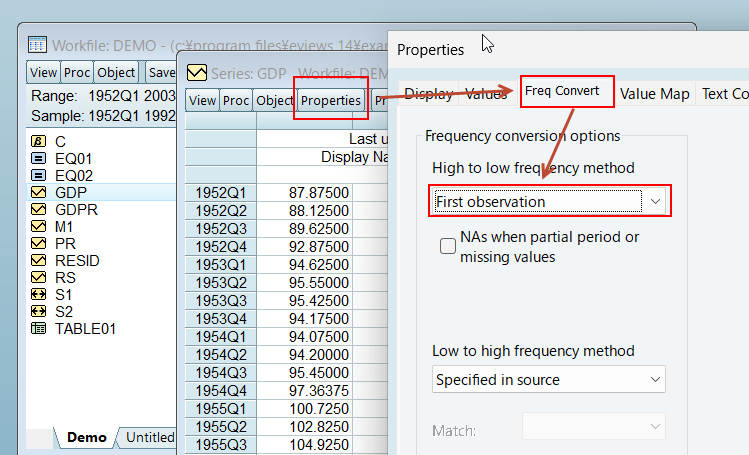
    デフォルトの変換手法はEViews全体または系列ごとに変更できます。系列ごとにデフォルトを設定する場合、対象のシリーズオブジェクトを開き、オブジェクトPropertiesボタンをクリックし、Freq Convertタブを開きます。
    データ
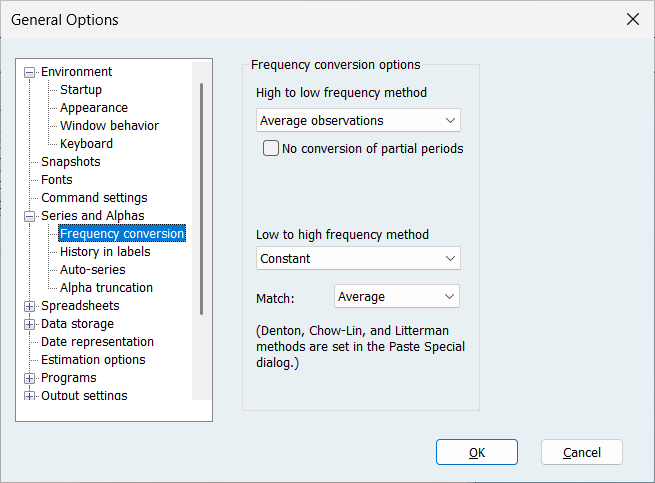
    EViews全体で変更したい場合は、トップメニューのOptions/General optionsを選択し、Series and AlphasツリーのFrequency conversionをクリックします。
    データ

変換手法(高頻度から低頻度)

  1. 高頻度から低頻度へのダウンコンバージョンでは、以下の9種類の変換手法を提供します。
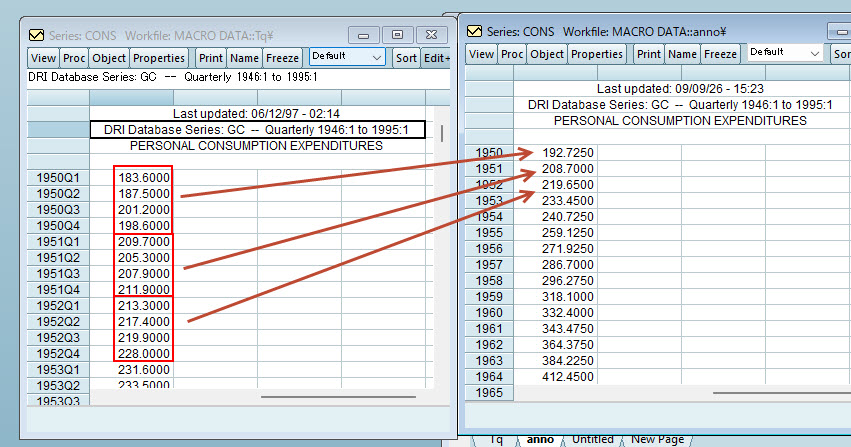
    • Average observations: 欠損していない観測値の平均。四半期から年次データに変換する場合、年内の4四半期の数値の平均が対応する年の代表値となります。
      データ
    • Sum observations: 欠損していない観測値の合計。四半期から年次データに変換する場合、年内の4四半期の数値の合計が対応する年の代表値となります。
    • First observation: 欠損していない最初の観測値。四半期から年次データに変換する場合、年内の第一四半期の数値が対応する年の代表値となります。第一四半期がNAの場合、第二四半期の数値が用いられます。
      データ
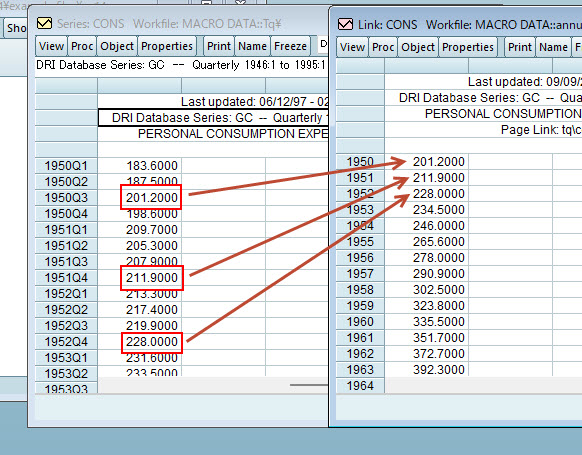
    • Last observation: 欠損していない最後の観測値。四半期から年次データに変換する場合、年内の第四四半期の数値が対応する年の代表値となります。第4四半期がNAの場合、第3四半期の値が利用されます。
    • Max observation: 欠損していない最大の観測値。四半期から年次データに変換する場合、年内の四半期のうち最大の数値が対応する年の代表値となります。
      データ
    • Min observation: 欠損していない最小の観測値。四半期から年次データに変換する場合、年内の四半期のうち最小の数値が対応する年の代表値となります。
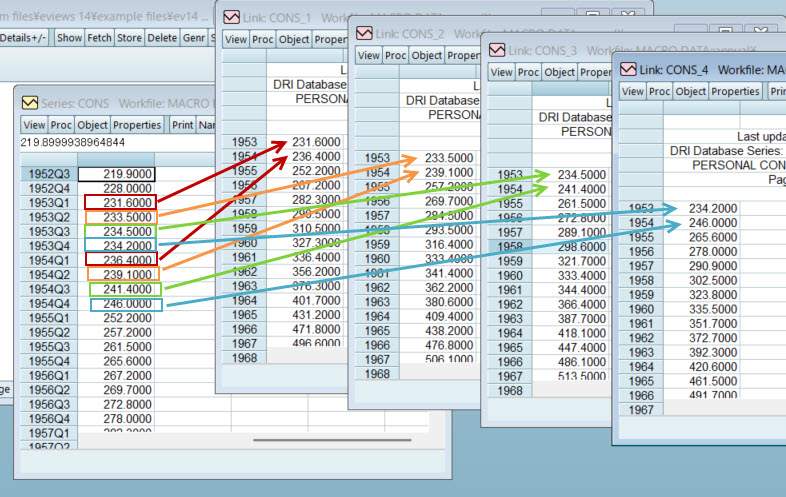
    • Split observations: 高頻度データの各期ごとの最初の値にインデックスを付けた変数を複数作成します。四半期から年次の変換では、x_1(第一四半期), x_2(第二四半期), x_3(第三四半期), x_4(第四四半期)の4系列を作成します。
      データ
    • Split last observations: 高頻度データの各期ごとの最後の値にインデックスを付けた変数を複数作成します。スプリットオブザベーションの逆です。四半期から年次の変換では、x_1(第四四半期), x_2(第三四半期), x_3(第二四半期), x_4(第一四半期)の4系列を作成します。
    • No down conversion: データの変換を行いません。

変換手法(低頻度から高頻度)

  1. 低頻度データから高頻度データへのアップコンバージョンでは、以下の9種類の変換手法を提供します。
    低周波数系列を観測しても、高周波数で同じ系列を観測する場合に比べて得られる情報は根本的に少ないため、一般的に低周波データから高周波系列を復元することはできません。したがって、EViewsの補間方法による結果は、基となる系列の真の値を示すものではなく、あくまでも参考値として捉えるべきです。
    Denton、Chow-Linn、Littermanの手法は、ベンチマーク系列を選択する必要があるため、前述の「デフォルトの変換手法の変更 」では選択できません。「コピーアンドペースト」でPaste specialを選択します。
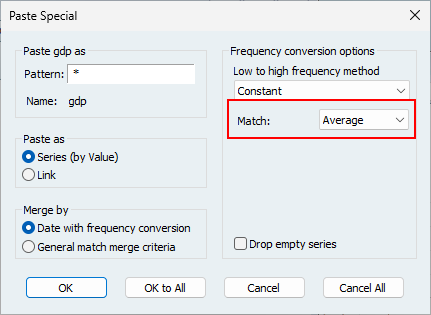
    • Constant: 特定の低周波期間に関連付けられた高周波系列のすべての観測値に同じ値が割り当てられます。Match:欄でAverageを選択した場合、値は高周波観測値の平均が低周波観測値と一致するように選択されます(値が単純に繰り返されます)。Sumの場合、値は高周波観測値の合計が低周波観測値と一致するように選択されます(値が観測値の数で割られます)。
      データ
    • Quadratic: 低周波系列の各観測値に対して局所的な二次多項式を当てはめ、この多項式を用いて、該当期間に関連付けられた高周波系列のすべての観測値を補間します。二次多項式は、元系列から隣接する3点のセットを取り、高周波点の平均値または合計が実際に観測された低周波データと一致するように二次式を当てはめます。
      この方法は純粋に局所的な方法で、結果として得られる補間曲線は、隣接する期間の境界で連続している必要はありません。そのため、この方法は、補間するデータ点が比較的少なく、元のデータが比較的滑らかな場合に適しています。
    • Linear: この方法は、低周波系列の各値を、その低周波期間に関連付けられた最初または最後の高周波観測値に割り当て、中間点をすべてこれらの点を結ぶ直線上に配置します。
    • Cubic: この方法は、低周波系列の各値を、その低周波期間に関連付けられた最初または最後の高周波観測値に割り当て、すべての中間点を、すべての点を結ぶ自然三次スプライン上に配置します。
    • Point: 低周波データを対応する高周波範囲の最初または最後の観測値に単純にコピーするだけです。その他の時点は欠損値となります。
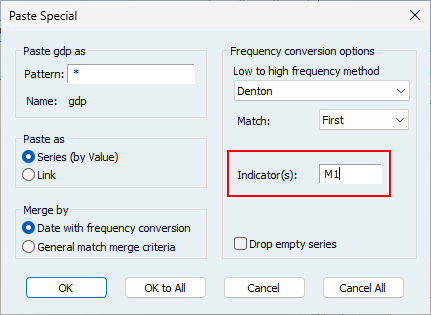
    • Denton: この手法では、高頻度系列$z$を低頻度のベンチマーク系列$y$に関連付けることで補完系列$x$を導きます。高頻度ベンチマーク系列の名前はIndicator(s)欄に入力します。
      データ
      これは、Denton (1971)が提案した比例一次差分関数を最小化することによって行われます。 \[ F = \sum_{t = 1}^{T}(\frac{x(t)}{z(t)}-\frac{x(t-1)}{z(t-1)})^2 \] これは、以下の制約条件を満たす制約付き最適化問題として解くことができます。 \[ \sum_{t=b_{k}}{e_{k}} \] $y$は各期間$k$におけるベンチマーク系列、$b_{k},e_{k}$は各期間の始点と終点です。ストック変数では補完系列がベンチマーク$y_{k}$を等しくなる特定の時点($b_{k}=e_{k}$)において制約が課されます。フロー変数では各$k$期間における補完系列の平均または合計が同期間のベンチマーク$y_{k}$と等しくなります。フロー変数の場合、このプロセスは補間ではなく、時間的分布/分解と呼ばれることもあります。EViewsは、補間系列の冒頭にある一時的な動きを除去するために、Cholette (1984)が改良した方法を採用しています。
    • Chow-Linn: Chow-Lin法は系列$x$の値を関連する高頻度系列$Z$から低頻度ベンチマーク系列に次の式を用いて導き出します。 \[ x(t) = Z(t) \beta + \alpha (t) \] $\beta$は係数ベクトル、$a(t)$は平均ゼロと共分散行列$V$のランダム数です。Chow and Lin (1971)による元の解法では、誤差がAR(1)過程に従うと仮定して、一般化最小二乗法を用いて共分散行列を推定しますが、EViewsでは、状態空間モデルと、以下の時系列モデルを用いて状態を推定します。 \[ a(t) = \rho a(t-1) + \epsilon(t) \] ただし、$\epsilon(t) \sim N(0,\sigma^{2})$で$|\rho|<1$です。
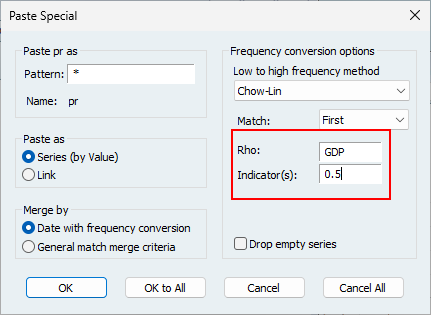
      $\rho$の値はRho欄で、高頻度のベンチマーク系列の名前はIndicator(s)欄に入力します。
      データ
    • Litterman: Chow-Lin法では補完系列の計算に共分散行列$V$に関する情報が必要ですが、通常は未知です。Littermanでは以下の条件を満たす残差から共分散行列を計算します。 \[ a(t)=a(t-1)+\epsilon(t) \] ただし$\epsilon \sim N(0,V)$です。 \[ \epsilon(t) = \rho \epsilon(t-1) + e(t) \] であり、初期状態は$a(0)=0$です。
      Chow-Linn同様、$\rho$の値はRho欄で、高頻度のベンチマーク系列の名前はIndicator(s)欄に入力します。
      データ
    • No up conversion: データの変換を行いません。
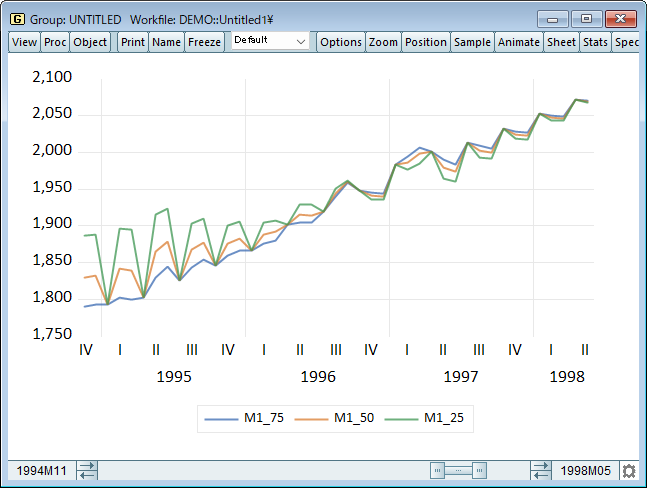
  2. Chow-LinnおよびLitterman法ではベンチマークとなる高頻度系列と$\rho$を指定します。$\rho$の値によって同じベンチマーク系列を参照しても、補完された系列は次のように異なります。
    データ
    青の線は$\rho=0.75$、オレンジの線は$\rho=0.50$、緑の線は$\rho=0.25$です。このデータでは、$\rho$が$1$に近づくほど滑らかな線になることがわかります。

参考文献

  1. Denton, F. T. (1971). “Adjustment of monthly or quarterly series to annual totals: an approach based on quadratic minimization,” Journal of the American Statistical Association, 66(333), 99-102.
  2. Cholette, P. (1984). “Adjusting sub-annual series to yearly benchmarks,” Survey Methodology, 10, 35-49.
  3. Chow, G. C., & Lin, A. L. (1971). “Best linear unbiased interpolation, distribution, and extrapolation of time series by related series,” The Review of Economics and Statistics, 53(4), 372-375.
  4. Litterman, R. B. (1983). “A random walk, markov model for the distribution of time series,” Journal of Business and Statistics, 1, 169-173.
page_top_icon